De eerste PC's · 04 / 11
Turbo Pascal, Turbo Vision en dBASE
Na PowerBASIC kwam Turbo Pascal.
Scroll verderBeeldbron
Historisch SC386SX-moederbord — Rjluna2 / Wikimedia Commons, CC BY-SA 4.0. Voor deze header uitgesneden en verkleind; AVIF/WebP-export. De afgeleiden behouden dezelfde licentie.

04 · Turbo Pascal
Turbo Pascal, Turbo Vision en dBASE.
Een andere taal, een andere manier van denken

Na PowerBASIC kwam Turbo Pascal. Dat was een flinke omschakeling. De taal zag er anders uit en dwong me om mijn programma's op een andere manier te structureren. Ineens waren er begin- en end-blokken, declaraties en het bekende := voor een toekenning. Eén = werd gebruikt voor vergelijkingen.
En dan die puntkomma. In Pascal is dat een scheidingsteken tussen opdrachten, niet letterlijk een verplicht karakter achter elke broncoderegel. Maar als je uit BASIC kwam, voelde het wel alsof de taal er voortdurend op stond dat je overal puntkomma's zette.
Pascal maakte veel sterker onderscheid tussen typen en structuren. Je kon gegevens en procedures helder organiseren, en in latere Turbo Pascal-versies ook objectgeoriënteerd programmeren. Dat laatste vond ik in het begin behoorlijk lastig. Je kende een probleem, je wist welke handelingen er nodig waren, en nu moest je ineens gaan nadenken in objecten met eigenschappen en gedrag.
Als voorbeeld: Een automaat waar je geld in stopt, een keuze maakt en vervolgens iets uit krijgt: zo'n 'vending machine'. Dit was een goede en begrijpelijke metafoor. Maar tussen een metafoor begrijpen en je eigen programma op die manier ontwerpen zat nog een behoorlijke stap.
Langzaam begon het te landen. De taal en de omgeving boden ruimte om grotere programma's netter op te bouwen. Die omschakeling was soms lastig, maar juist dat hield me bezig.
Turbo Vision: Windows zonder Windows
Turbo Vision vond ik echt bijzonder en in zeker opzicht revolutionair. Je werkte nog gewoon in de tekstmodus van DOS, maar kon een gebruikersinterface maken met overlappende vensters, menu's, dialoogvensters, invoervelden, lijsten en muisbediening. Vensters konden bewegen; de achtergrond werd weer zichtbaar wanneer je ze verplaatste. Het had allerlei eigenschappen van een grafische omgeving, zonder dat er een echte pixelgebaseerde Windows-interface aan te pas kwam. Vergelijkbare tekstinterfaces kende ik al van PC Tools en Norton Commander. Die waren niet allemaal met Turbo Vision gebouwd. Maar nu kon je er zélf mee aan de slag.
Turbo Vision 2.0 in een moderne C++-uitvoering, gebaseerd op het oorspronkelijke Borland-framework.
Beelden: magiblot — tvision en tvterm. Met toestemming van de maker.
Door het werken in tekstmodus voelde het vaak razendsnel. Maar de belangrijkste ontdekking zat dieper: het programma reageerde op gebeurtenissen.
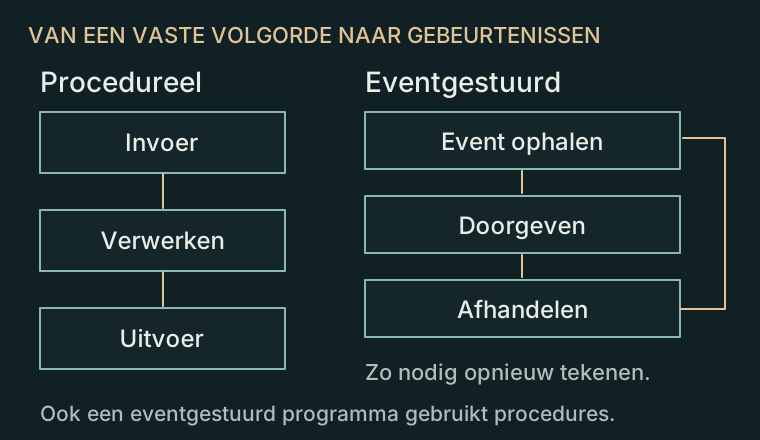
Bij klassieke procedurele programma's bepaalde je grotendeels zelf de volgorde: vraag invoer, bereken iets, druk een resultaat af. Bij een eventgestuurde interface wacht het programma voortdurend op wat er gebeurt. De gebruiker klikt op een knop, opent een menu, verplaatst een venster, typt iets in — en de applicatie moet daarop reageren.
Dat was een nieuwe manier van programmeren. Later, bij Windows, zou die gedachte terugkomen in een veel uitgebreidere vorm.
Hoe Turbo Vision events, vensters en overlap afhandelde
Turbo Vision bouwde een scherm uit views: onderdelen zoals een invoerveld, lijst of knop. Een TGroup groepeerde zulke onderdelen; vensters en dialoogvensters waren gespecialiseerde groepen. Zo kon een venster zijn eigen onderdelen beheren, terwijl de toepassing het bureaublad en de menu's beheerde.
De eventloop haalde muis-, toetsenbord- en opdrachtgebeurtenissen op. Een groep gaf ze door volgens onder meer focus en eventtype. Het betrokken onderdeel verwerkte de gebeurtenis en kon aangeven dat deze was afgehandeld. Een menuopdracht kon zo een dialoog openen, zonder dat de hoofdcode vooraf iedere handeling in een vaste volgorde uitschreef.
Daarnaast waren er berichten tussen onderdelen en broadcasts naar een groep. Niet ieder bericht was dus letterlijk een muisklik. Een command kon ook een verzoek uit een ander onderdeel van de toepassing vertegenwoordigen.
Vensters hadden een volgorde, begrenzing en eigenaar. De tekenroutines hielden rekening met clipping: alleen het zichtbare deel hoorde op het scherm. Wanneer een venster werd verplaatst of gesloten, moest de onderliggende inhoud weer worden getekend, zo nodig vanuit een buffer. Het scherm bestond nog steeds uit tekstcellen, met tekens en kleurattributen.
Procedurele code verdween niet. Een gebeurtenis riep juist een gewone procedure of methode aan. Het verschil zat in wie de volgorde bepaalde: de gebruiker en de gebeurtenissen, in plaats van één vooraf vastgelegde reeks vragen.
De gebeurtenisnamen in het schema zijn beschrijvend. De illustratie is geen oorspronkelijk Turbo Vision-scherm en ook geen kopie van mijn spoorwerkbeheerprogramma.
Technische basis: Borland, Turbo Vision Programming Guide (1992), hoofdstukken over views, events, groups en drawing.
dBASE: gegevens kregen structuur
Met dBASE ging ook het werken met gegevens een stap verder. Ik had tot dan toe veel zelf opgelost met invoer- en uitvoerroutines: records schrijven, records lezen, zorgen dat de structuur overal klopte. Dat kon prima, zolang de gegevens overzichtelijk bleven. Maar hoe groter een toepassing werd, hoe lastiger het werd om opslag, zoeken, wijzigen en samenhang zelf te regelen.
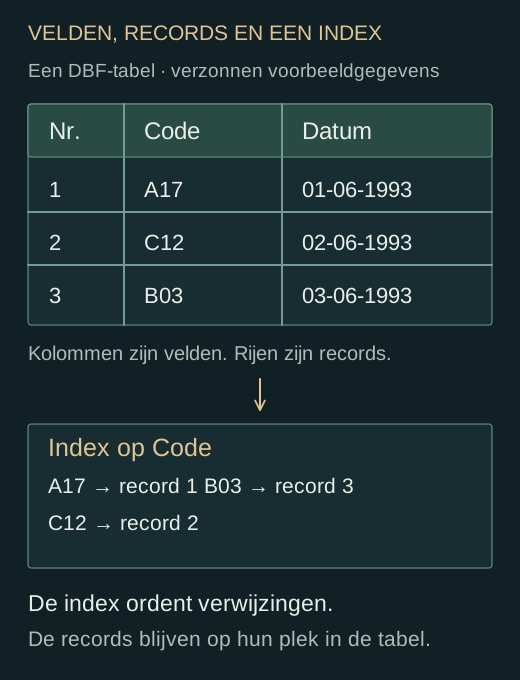
Een databaseomgeving bood tabellen, velden, indexen en manieren om gegevens doelgericht terug te vinden. Dat was voor mij een heel andere benadering. De informatie stond niet langer uitsluitend als een door mij zelf gekozen reeks bytes in een bestand; je kon haar ook behandelen als afzonderlijke gegevens die een betekenis hadden en logisch met andere gegevens samenhingen.
dBASE en de .DBF-bestanden waren overigens niet echt hetzelfde als een moderne relationele SQL-database met alle bijbehorende voorzieningen. Je moest relaties en samenhang nog steeds bewust programmeren. Juist daarom vond ik het interessant: de opslag en toegang waren veel rijker dan bij zelfgeschreven platte bestanden, terwijl er voor de programmeur nog genoeg viel uit te zoeken.
Ook de tekstgebaseerde interfaces werden steeds verzorgder. Een toepassing kon beginnen met een eenvoudige lijst van keuzes en uitgroeien tot een compleet scherm met vensters, menu's en invoervelden. Bij het spoorwerkbeheerproject heb ik daar veel mee gedaan.

Een bestand is nog geen database
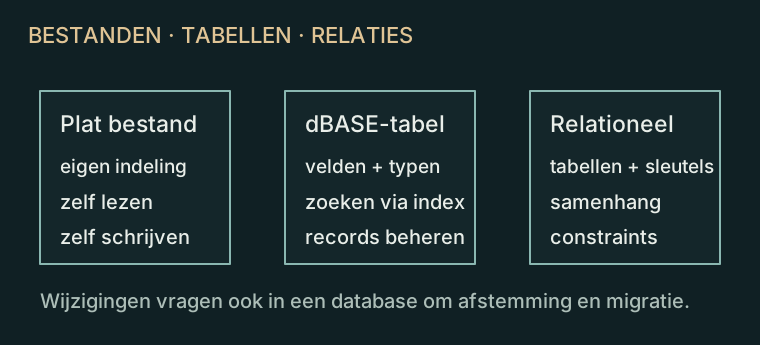
Bij een zelf beschreven bestand moet je de recordindeling zelf consequent lezen en schrijven. dBASE bood velddefinities, records en indexen om toegang tot gegevens te organiseren. Een relationeel databasesysteem voegt onder meer sleutels, relaties en mogelijkheden voor het bewaken van samenhang toe.
Ook dan blijven goede modellering en applicatielogica nodig. Een nieuw veld of een gewijzigde relatie kan een migratie en aangepaste code vragen. Het voordeel is meer ondersteuning en een duidelijker scheiding tussen toepassing en gegevensbeheer, niet dat wijzigingen vanzelf veilig zijn.
Zelf software maken, omdat het kon
Ik programmeerde intussen van alles. Een adressenboekje, een programma voor visitekaartjes, iets voor recepten, een catalogus van mijn lp's. Telkens een ander probleem, telkens een nieuwe reden om uit te zoeken hoe iets werkte.
Het ging lang niet alleen om het eindresultaat. Ik vond het oprecht leuk om een probleem te begrijpen, een oplossing te bedenken en vervolgens te zien dat die werkte. Bij de TRS-80 was dat begonnen met Galgje. Nu werden de toepassingen groter en technisch ingewikkelder. Ik merkte dat dit werk me goed lag. Niet omdat alles meteen lukte, maar omdat ik bleef puzzelen tot ik begreep hoe het zat.
Beeldbronnen en technische achtergrond bij dit hoofdstuk
- Turbopascal 6.png — Tors; eerdere upload Rehro. Publiek domein · PD-ineligible. De getoonde versie bepaalt niet welke versie ik destijds gebruikte.
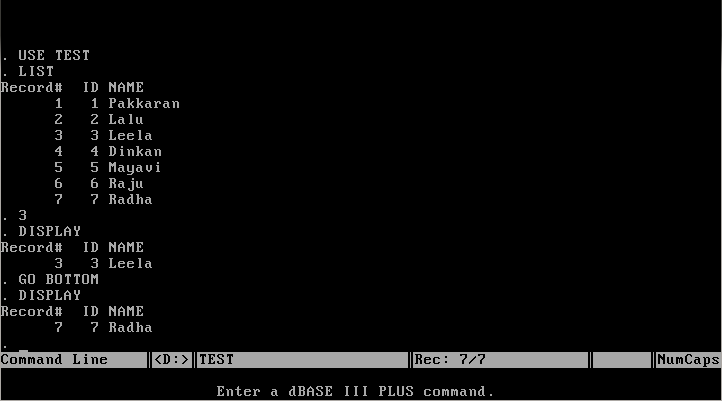
- Screenshot of Dbase III Plus.png — Vssun. Publiek domein · PD-ineligible. De getoonde versie bepaalt niet welke versie ik destijds gebruikte.
Technische bronnen: Borland, Turbo Vision Programming Guide (1992), dBASE over indexeren en sorteren, en de DBF-formaatdocumentatie van dBASE. Die laatste beschrijft een later formaat; het schema toont alleen het algemene principe van velden en records, geen exacte indeling van een dBASE-IV-bestand.
TERUG NAAR DE EERSTE PC'S